
Guía práctica · R base
Publicado el
Ensayos de un brazo: respuesta y denominadores
Aprende a auditar una proporción de respuesta antes de interpretarla: reconstruye los recuentos, calcula su incertidumbre y comprueba qué cambia al excluir resultados desconocidos.
Descargar el script RVer los pasosLeer la noticia y su contexto regulatorio
- Guarda el script en una carpeta propia.
- Ábrelo en RStudio y ejecuta source("response-denominators.R").
- Ejecuta run_exercise("downloads"); consulta abajo los resultados y sus límites.
28 personas. Dos denominadores.
Duración documentada de respuesta de al menos 12 meses, en la población de eficacia con CIS.
Entre quienes respondieron
28 / 4858,3%
Sobre la cohorte inicial con CIS
28 / 7736,4%
Trabajaremos con dos materiales separados: recuentos agregados publicados por la FDA para la población con CIS de Anktiva y un ejercicio completamente sintético de 100 personas. Ningún archivo contiene datos individuales del ensayo. El objetivo es descriptivo y docente; no evaluaremos una indicación clínica ni compararemos tratamientos.
1. Define la cantidad antes de abrir R
La unidad es la persona. Para una respuesta binaria necesitas un numerador, un denominador y una regla de evaluación. «Respuesta en algún momento» y «respuesta en la visita del mes seis» son variables distintas, aunque ambas estén codificadas con cero y uno. Deben fijarse también la población elegible, el calendario y el tratamiento de rescates, fallecimientos y evaluaciones ausentes. Una columna numérica válida no garantiza que su significado sea correcto.
En esta práctica, x es el número de respuestas y n el número de personas de la población correspondiente. No hay predictores ni ajuste por covariables: calculamos una proporción descriptiva y un intervalo binomial. La interpretación como probabilidad común requiere observaciones independientes bajo el modelo elegido. Datos repetidos por visita, agrupados por centro o con diferentes oportunidades de respuesta pueden requerir otro análisis.
El diccionario del ejemplo sintético contiene id, identificador único con prefijo SYN, y response: 1 significa respuesta documentada al horizonte docente, 0 no respuesta documentada y una celda vacía resultado desconocido. Las cien personas pertenecen a la población definida antes de observar el desenlace. No son los 77 participantes de eficacia de Anktiva.
2. Reproduce una estimación agregada publicada
El Snapshot de la FDA publica 48 respuestas entre 77 personas con CIS, con o sin enfermedad papilar. Este dato se utiliza como ejemplo de auditoría aritmética. No se atribuye a la población exclusivamente papilar incorporada en octubre ni se reconstruyen registros individuales a partir de los totales.
source("response-denominators.R")


response_summary(48, 77)


stats::binom.test(48, 77, conf.level = 0.95)$conf.int
Resultado: proporción 0,6233766; límites 0,5056248 y 0,7313324. En porcentaje, 62,34% e IC del 95% de 50,56% a 73,13%. La función usa Clopper–Pearson. Su cobertura es al menos la nominal bajo el modelo binomial y puede ser conservadora. La interpretación es frecuentista: el procedimiento tiene una propiedad de cobertura en repeticiones; no asigna una probabilidad del 95% a este parámetro fijo. Documentación oficial de R.
Un intervalo cuantifica una fuente de incertidumbre. No corrige reclutamiento selectivo, ausencia informativa ni clasificación errónea del desenlace. Tampoco estima una diferencia frente a un control inexistente. Aunque binom.test devuelva un valor p, aquí extraemos solo el intervalo: no hemos definido un umbral histórico clínicamente justificable para formular un contraste.
3. Comprueba qué ocurre al cambiar el denominador
Los recuentos publicados para duración son 28 y 19, con denominador 48 respondedores. Su relación con las 77 personas se obtiene mediante aritmética, manteniendo la definición de cada fila. El archivo fda-denominators.csv conserva numerador, denominador, proporción y procedencia. Las filas derivadas están identificadas como cálculos descriptivos propios.
48 / 77                 # respuesta en algún momento


28 / 48                 # duración >=12 meses entre respondedores


19 / 48                 # duración >=24 meses entre respondedores


(48 / 77) * (28 / 48)    # exactamente 28/77


28 / 77                 # recuento documentado sobre la población inicial
El último resultado es 36,36%. No lo llames supervivencia libre de enfermedad a los 12 meses desde el inicio. El reloj de duración arranca en la respuesta y puede comenzar en distintas visitas. Un recuento documentado tampoco ajusta por censura ni por tiempo insuficiente de observación. La identidad algebraica sigue siendo cierta, pero su nombre científico debe corresponder a lo calculado.
Si necesitas analizar duración con datos individuales, define el evento, el origen temporal y las reglas de censura. El fallecimiento puede ser un evento del desenlace o un riesgo competitivo según la pregunta; no se convierte automáticamente en censura independiente. La guía publicada de Kaplan–Meier desarrolla tiempo, censura y personas en riesgo. No añadimos una curva inventada de Anktiva para completar este ejercicio.
4. Separa precisión de magnitud
Las muestras sintéticas de 20, 80 y 200 personas tienen exactamente el 60% de respuesta: 12, 48 y 120 respuestas. Sus intervalos exactos difieren. Un denominador mayor aporta precisión bajo el mismo modelo; no vuelve causal una estimación descriptiva. Son escenarios separados, no tres momentos de un seguimiento acumulativo.
| Respuesta / total | Respuesta (%) | IC exacto 95% (%) |
|---|---|---|
| 12 / 20 | 60,0 | 36,05 – 80,88 |
| 48 / 80 | 60,0 | 48,44 – 70,80 |
| 120 / 200 | 60,0 | 52,85 – 66,85 |
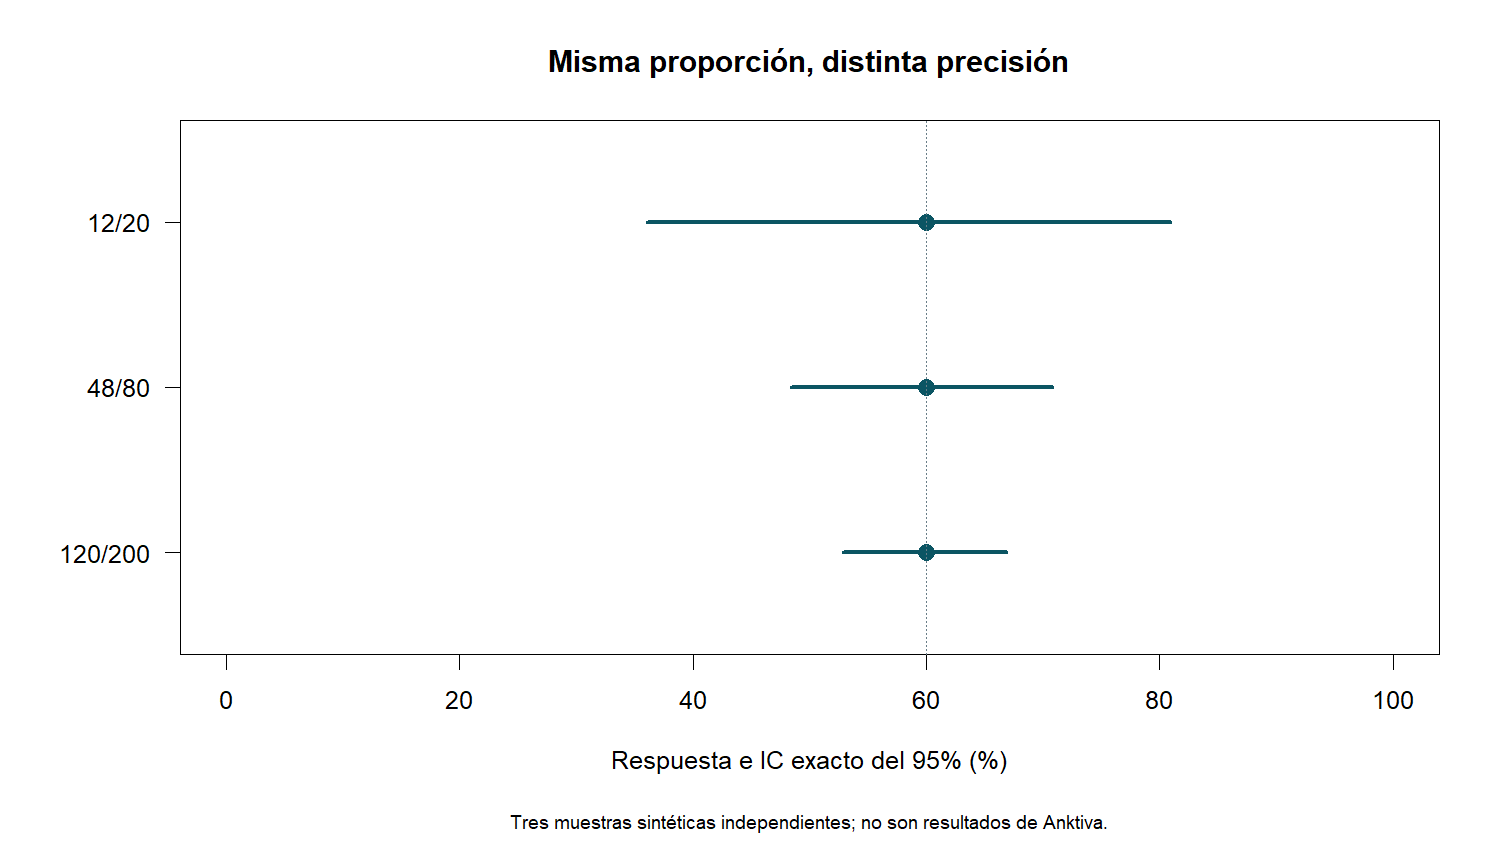
La figura conserva una escala de 0 a 100% para no exagerar las diferencias de amplitud. No representa la probabilidad de que un paciente concreto responda ni una jerarquía de eficacia entre estudios. Para comparar poblaciones o intervenciones hacen falta diseño y estimando apropiados, además de un intervalo.
5. Explora diez respuestas desconocidas
El CSV sintético contiene 60 respuestas, 30 no respuestas y 10 valores desconocidos. La proporción entre observados es 60/90 = 66,67%. Esa cantidad describe a quienes tienen dato. No pasa a representar automáticamente a las cien personas porque la operación elimine los valores vacíos sin errores.
d <- read.csv("downloads/synthetic-response.csv")


mean(d$response, na.rm = TRUE)


missing_scenarios(d$response)
La función conserva cien personas en el denominador y asigna sucesivamente entre cero y diez respuestas a los desconocidos. Produce once completados, desde 60/100 hasta 70/100. El rango 60–70% es un límite de completado de la proporción de esta muestra. No es un intervalo de confianza, una imputación múltiple ni una prueba de que todos esos completados sean igualmente probables.
MCAR, MAR y MNAR describen supuestos diferentes sobre la ausencia. El ejercicio no identifica cuál se cumple. Para interpretar los casos completos como estimación de la población original necesitarías justificar el mecanismo y las condiciones pertinentes. Asignar todos los desconocidos a no respuesta puede ser una regla conservadora para una variable concreta, pero debe estar definida y no equivale a demostrar que los resultados realmente fueron negativos.
6. Evita una comparación histórica improvisada
Supón que encuentras un estudio anterior con una respuesta del 40%. Restar ese valor al 62,34% no identifica un beneficio causal de 22,34 puntos. Las poblaciones, la definición, las visitas, la resección previa y el manejo de faltantes pueden ser distintos. Incluso el denominador podría incluir personas distintas de las consideradas elegibles en el estudio actual.
Una comparación externa requiere un protocolo propio: elegibilidad común, origen temporal, estrategia frente a confusión y análisis de sensibilidad. El ajuste por variables observadas no garantiza ausencia de confusión residual. En esta guía no calculamos RR, NNT ni superioridad entre tratamientos porque los recuentos disponibles no sustentan esas estimaciones. La guía FDA sobre desenlaces oncológicos sitúa la elección del diseño y del resultado en su contexto.
7. Ejecuta y conserva la procedencia
Descarga el script en una carpeta propia, ábrelo en RStudio y ejecuta los comandos siguientes desde esa carpeta. No instala paquetes ni modifica tus datos. Escribe archivos con nombres conocidos en el directorio de salida que indiques; elige una carpeta nueva si quieres conservar una ejecución anterior.
source("response-denominators.R")


run_exercise("downloads")


d <- read.csv("downloads/synthetic-response.csv")


response_summary(sum(d$response == 1, na.rm = TRUE),


                 sum(!is.na(d$response)))


range(missing_scenarios(d$response)$estimate)Los resultados son deterministas: no hay simulación aleatoria ni semilla que recuperar. El script utiliza R base y los paquetes incluidos stats, graphics y grDevices. El registro sessionInfo.txt conserva la versión realmente ejecutada. Los archivos FDA son agregados derivados; los identificadores SYN pertenecen únicamente al ejemplo sintético. Nunca mezcles ambos orígenes en un único conjunto de pacientes.
8. Cuatro ejercicios con solución
1. ¿El 58% significa respuesta duradera en el 58% de las 77 personas?
No. El denominador publicado es 48 respondedores: 28/48 = 58,33%. Sobre las 77 personas, el recuento documentado corresponde a 28/77 = 36,36%. Esta transformación no estima por Kaplan–Meier la duración ni una respuesta en una visita fija desde el inicio.
2. ¿Por qué 12/20 y 120/200 no tienen el mismo intervalo?
Ambos dan 60%, pero el tamaño de muestra difiere. Reproduce response_summary(12,20) y response_summary(120,200). El segundo intervalo es más estrecho bajo el modelo binomial. Ninguno informa por sí solo de eficacia comparada ni de transportabilidad.
3. Si ocho de los diez desconocidos respondieron, ¿qué proporción obtienes?
La muestra completada tiene 68 respuestas sobre cien: 68%. Busca missing_responders_assumed == 8 en el CSV de sensibilidad. Es un supuesto explícito, no un resultado observado. Los casos completos siguen dando 66,67%, porque siguen respondiendo otra pregunta.
4. ¿Puedes usar 48/77 como tasa observada de la nueva población papilar?
No. El agregado procede de la población con CIS. La ampliación regulatoria usa un argumento de extrapolación, no cambia retrospectivamente la población de ese recuento. Una tabla correcta debe conservar población, fuente, definición y fecha.
9. Cómo escribir un resultado auditable
Una formulación útil sería: «En la población de eficacia con CIS descrita por la FDA, hubo 48 respuestas completas en algún momento entre 77 personas; proporción recalculada 62,34%, IC binomial exacto del 95% 50,56–73,13%. No hay brazo comparador en este agregado». Añade después el resultado de duración con su denominador propio.
Para tu proyecto, conserva en el diccionario la definición del desenlace, las reglas de ausencia y las fechas de corte. Si cambias una decisión tras ver resultados, regístrala como una decisión posterior y compara su impacto con la especificación original. Una ejecución reproducible permite auditar qué hiciste; la validez científica exige además justificar por qué esa operación responde a la pregunta.