
Actualidad farmacéutica · Lectura crítica · 18 octubre 2026
Satralizumab y SatraGO: un ensayo significativo y otro no, ¿qué podemos concluir?
La noticia regulatoria invita a mirar más allá del valor p: qué efecto se ha estimado, con cuánta incertidumbre y qué supuestos llevaríamos al siguiente ensayo.
La respuesta breve: dos etiquetas de significación distintas no demuestran que los efectos difieran entre estudios. Tampoco convierten ambos resultados en equivalentes. Para interpretar la evidencia necesitamos las estimaciones, sus intervalos y el diseño que les da significado.
Ir a la guía práctica y reproducir los escenarios en Trial Planner y R
1. Qué ha ocurrido y qué parte es nueva
Roche comunicó el 16 de octubre la aprobación estadounidense de Enspryng, satralizumab, para adultos con enfermedad ocular tiroidea. Genentech había publicado su anuncio estadounidense el día 15. Esos anuncios constituyen la actualidad de esta pieza; no deben confundirse con la fecha de generación de los datos. La publicación de los resultados a 24 semanas de SatraGO-1 y SatraGO-2 apareció en línea el 7 de septiembre de 2026, y hubo comunicaciones de resultados anteriores. Roche · Genentech · Publicación científica.
El interés bioestadístico está en la combinación de dos estudios de diseño semejante con resultados que reciben etiquetas distintas frente al umbral de significación. La aprobación es una decisión regulatoria. Nuestro objetivo aquí es explicar cómo leer los estudios y trasladar sus preguntas al diseño de una investigación futura. No reconstruimos la evaluación completa de la agencia ni atribuimos a un único contraste toda la decisión.
2. Qué se comparó y cuál era la pregunta
SatraGO-1 y SatraGO-2 son ensayos fase III, multicéntricos, aleatorizados y enmascarados frente a placebo. Incluyeron 131 y 127 participantes, respectivamente, con enfermedad activa o inactiva. El desenlace principal correspondía a la población con enfermedad activa: respuesta de proptosis a las 24 semanas. La definición exigía una reducción de al menos 2 mm en el ojo de estudio sin empeoramiento de al menos 2 mm en el otro ojo. La unidad aleatorizada era la persona; disponer de dos ojos no duplica el tamaño de muestra independiente. Artículo · Presentación de los investigadores, diapositiva 7.
Una respuesta dicotómica transforma una medición continua en una decisión: cumplir o no una regla. El umbral individual de 2 mm y la diferencia entre proporciones de respondedores son cantidades distintas. La primera define quién responde; la segunda describe cuánto cambia la probabilidad de respuesta entre grupos. Tampoco responde por sí sola a preguntas sobre duración del beneficio, preferencias del paciente o comparación con un tratamiento activo.
3. Magnitud del efecto, intervalo y valor p
| Ensayo | Tratamiento | Placebo | RD ajustada (pp) | IC 95,03% (pp) | p |
|---|---|---|---|---|---|
| SatraGO-1 | 49,0% | 31,2% | 17,9 | -1,6 / 37,3 | 0,0715 |
| SatraGO-2 | 52,9% | 23,4% | 28,9 | 11,5 / 46,2 | 0,0011 |
Población con enfermedad activa, semana 24. Diferencias ajustadas e IC del 95,03% publicados; se conserva el nivel de confianza original. Fuente: Briceño y colaboradores, Ophthalmology. Las proporciones publicadas pueden incorporar el procedimiento de estimación y datos faltantes: no deben convertirse en recuentos por multiplicación.
La diferencia ajustada compara tratamiento menos placebo, en puntos porcentuales; valores positivos favorecen la respuesta con tratamiento. Es importante conservar la estimación publicada: restar porcentajes redondeados produciría 17,8 o 29,5 puntos, que no son las diferencias ajustadas de 17,9 y 28,9. Un cambio aparentemente pequeño en la presentación puede ocultar que se están mezclando análisis distintos.
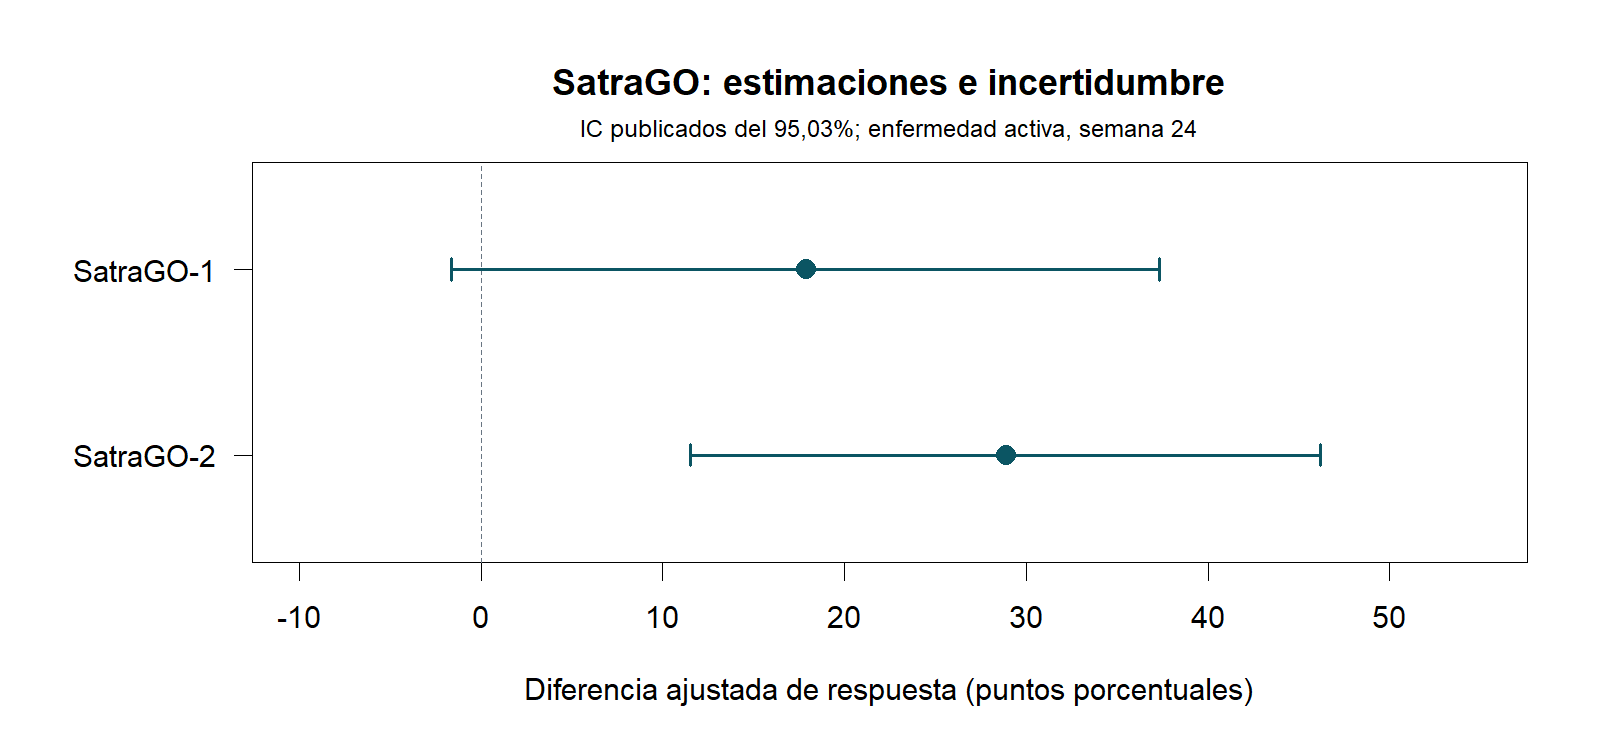
En el primer estudio, el intervalo incluye cero y también beneficios considerables. La interpretación no es «se ha demostrado ausencia de efecto». En el segundo, el intervalo queda del lado favorable para este desenlace y población; eso no elimina la incertidumbre sobre su magnitud. Conviene leer ambos intervalos antes de resumir la evidencia con una palabra.
Un intervalo frecuentista tampoco asigna una probabilidad posterior del 95,03% a que el verdadero efecto esté dentro de esos límites concretos. Su cobertura se refiere al comportamiento del procedimiento en repeticiones bajo sus supuestos. Para una decisión clínica, la pregunta adicional es qué magnitudes serían suficientemente importantes dadas las cargas, riesgos y alternativas.
4. Dos valores p no son una prueba de diferencia entre efectos
El contraste de cada ensayo pregunta por su comparación de tratamiento frente a placebo. Una comparación entre ensayos plantea otra hipótesis: si los efectos de tratamiento difieren. Conocer que uno rebasa un umbral y el otro no no resuelve esta segunda pregunta. Esta es la advertencia metodológica clásica de Gelman y Stern.
También sería incorrecto dar el salto inverso y afirmar que los efectos son iguales porque los intervalos se solapan. El solapamiento visual no sustituye una comparación formal, y no encontrar heterogeneidad tampoco prueba equivalencia. Una síntesis adecuada tendría que revisar la compatibilidad de población, desenlace, estimando y métodos, además de la incertidumbre estadística.
En estos estudios cambiaron tanto la respuesta estimada con tratamiento como la del grupo placebo. Esa observación merece atención, pero no identifica su causa. No permite atribuir automáticamente la diferencia a selección de centros, gravedad, adherencia o medición. Explicaciones de ese tipo necesitan datos y análisis específicos; presentarlas como hechos convertiría una hipótesis razonable en una conclusión no demostrada.
Un ejemplo completamente sintético
Imaginemos dos estimaciones independientes de diferencia de respuesta: 12 puntos con error estándar de 7 y 16 puntos con error estándar de 6. Con una aproximación normal, la primera tiene p≈0,086 y la segunda p≈0,0077. Sin embargo, la diferencia entre ambas estimaciones es de 4 puntos y su error estándar es aproximadamente 9,22: p≈0,664. Son números inventados para aislar el razonamiento, sin relación numérica con los participantes de SatraGO.
| Comparación | RD (pp) | IC 95% (pp) | p |
|---|---|---|---|
| A sintético | 12,0 | -1,7 / 25,7 | 0,0865 |
| B sintético | 16,0 | 4,2 / 27,8 | 0,0077 |
| B − A | 4,0 | -14,1 / 22,1 | 0,6644 |
El cálculo utiliza independencia entre estimaciones. Si procedieran de participantes compartidos o comparaciones correlacionadas, habría que incorporar la covarianza. El objetivo del ejemplo es mostrar por qué una etiqueta separada no responde a una comparación conjunta, no proporcionar una prueba alternativa para los ensayos reales.
5. Qué llevar al diseño del siguiente ensayo
Una tasa observada no se convierte automáticamente en una tasa futura conocida. Antes de calcular participantes, debemos decidir qué población queremos estudiar, cómo definiremos respuesta, cuándo la mediremos y qué diferencia sería importante y plausible. El tamaño muestral resulta de esas decisiones; un número preciso puede seguir estando apoyado en supuestos débiles.
En un ejemplo prospectivo sintético, supongamos respuesta del 25% con control y del 40% con tratamiento. Bajo el método normal de Trial Planner, alfa bilateral 0,05, potencia objetivo del 90% y asignación 1:1, hacen falta 203 resultados utilizables por grupo. Una retención común del 90% lleva a aleatorizar 226 por grupo, 452 en total. Esto no reproduce SatraGO, que tiene un análisis y una estructura propios.
La diferencia de 15 puntos de ese ejercicio es una elección docente. No representa un umbral clínico validado para enfermedad ocular tiroidea. La guía DELTA² sitúa la justificación del efecto objetivo, con evidencia y participación de las personas interesadas, en el centro del diseño. El efecto más optimista de un estudio anterior rara vez constituye por sí solo una justificación suficiente.
Por eso conviene explorar qué ocurre si el control responde más, si el beneficio es menor o si se pierden más mediciones. Mantener una diferencia absoluta constante y mantener un riesgo relativo constante describen alternativas distintas. Debemos declarar cuál utilizamos; cambiarlo silenciosamente entre escenarios hace que la comparación pierda significado.
6. Estimando, datos faltantes y multiplicidad
El material metodológico de SatraGO describe ponderación Mantel–Haenszel, estratificación e imputación múltiple bajo MAR para el desenlace principal. También distingue estrategias ante eventos intercurrentes. Estos elementos importan porque determinan qué comparación se estima y bajo qué supuestos. Un contraste de dos proporciones agregadas no reproduce necesariamente su estimación o incertidumbre. Métodos presentados.
Abandonar un tratamiento y no disponer de una medición son problemas relacionados, pero distintos. Puede medirse el desenlace después de suspender la intervención; también puede faltar una medición sin que se haya suspendido. El marco de ICH E9(R1) ayuda a formular primero la pregunta y después alinear los datos, el análisis y la sensibilidad. Inflar el reclutamiento no elimina el sesgo si la ausencia depende del resultado no observado.
La publicación indica además que el resultado principal de SatraGO-1 impidió continuar el contraste formal de desenlaces secundarios clave dentro de su jerarquía. No corresponde rescatar una conclusión confirmatoria seleccionando después un secundario con p pequeño. Los resultados nominales pueden ser informativos, siempre que se identifiquen como tales y se conserve su posición en la estrategia de multiplicidad.
7. Beneficio, seguridad y aplicabilidad
La conveniencia de una administración subcutánea y la mejora de un desenlace son dimensiones distintas del balance clínico. Los anuncios describen ausencia de señales nuevas de seguridad; eso no significa ausencia de riesgos ni demuestra superioridad de seguridad frente a otras opciones. La duración y el tamaño de los estudios limitan qué eventos poco frecuentes pueden caracterizar. Anuncio estadounidense.
La aplicabilidad exige preguntar si el paciente se parece a la población relevante y si el desenlace captura lo que importa para él. No extrapolamos automáticamente el resultado principal de enfermedad activa a cualquier forma o duración de la enfermedad. Tampoco deducimos una comparación con tratamientos activos a partir de estudios frente a placebo. Esas preguntas necesitan evidencia adicional y valoración clínica.
8. Practicar con una pregunta de diseño explícita
La guía de planificación con respuesta binaria desarrolla el caso del 25% frente al 40%, una matriz de nueve escenarios, el coste de asignar 2:1 y el tratamiento conceptual de resultados faltantes. Incluye un script autónomo de R, CSV sintéticos y ejercicios con solución. Cada resultado docente se mantiene separado de los resultados clínicos publicados.
Al terminar, el lector debería poder justificar sus entradas en Trial Planner, detectar cuándo el método resulta demasiado simple para su pregunta y comunicar un tamaño muestral junto con sus supuestos. Esa es una conclusión más útil para investigación que clasificar dos ensayos únicamente por su valor p.