
Guía práctica · Datos sintéticos
Kaplan–Meier, paso a paso
Lee una curva de supervivencia, entiende la censura y reproduce el resultado con un caso clínico ficticio.
01 · El caso clínico
El caso clínico
300 pacientes ficticios, 150 en A y 150 en B. ¿Qué probabilidad de estar vivo a los 12 meses desde el diagnóstico estimamos en cada grupo?
- Tiempo cero
- Diagnóstico oncológico
- Evento
- Fallecimiento por cualquier causa
- Seguimiento máximo
- 24 meses
A/B son etiquetas del ejercicio. Las cifras no representan una población clínica real ni tratamientos.
Definición del caso y qué aprenderás
Al terminar, sabrás estimar e interpretar la supervivencia a 12 meses, entender la tabla de personas en riesgo y reproducir el cálculo en R.
- Leer una curva Kaplan–Meier, sus marcas de censura y sus intervalos de confianza.
- Distinguir la probabilidad de supervivencia del número de personas que siguen en riesgo.
- Obtener los mismos resultados con Survival Lab y el paquete
survivalen RStudio usando los mismos datos.
Imagina una cohorte completamente ficticia de 300 adultos con un diagnóstico oncológico, seguida durante un máximo de 24 meses. A y B son dos grupos definidos al inicio, con 150 pacientes cada uno; son etiquetas del ejercicio, sin representar tratamientos ni categorías clínicas validadas. Queremos responder: ¿qué probabilidad de estar vivo a los 12 meses desde el diagnóstico estimamos en cada grupo?
La unidad de análisis es el paciente y el tiempo cero, su diagnóstico. El evento es el fallecimiento por cualquier causa. El tiempo observado termina en el fallecimiento, en el último contacto en que se confirma que el paciente está vivo si después se pierde el seguimiento, o en el cierre a los 24 meses. Los dos últimos casos son censura por la derecha: conocemos la supervivencia hasta ese momento, pero no lo que sucede después.
El estimando es la supervivencia marginal por grupo, S(t) = P(T > t), especialmente S(12). El grupo es el único factor de estratificación: no hay ajuste por covariables, contraste de hipótesis ni estimación causal. Los registros son simulados; el caso da contexto al ejercicio y sus cifras no describen una población clínica real.
02 · Explora cada escalón
Explora cada escalón
Ejemplo independiente de cinco personas: avanza por los meses y observa qué cambia con un evento y con una censura. No muestra intervalos de confianza.
- Supervivencia KM
- En riesgo justo antes
- Restantes después
Las cruces marcan censuras; la línea muestra la supervivencia Kaplan–Meier.
Cálculo del escalón:
Leer la explicación y la tabla completa
| Mes | En riesgo antes | Eventos | Censuras | KM después |
|---|---|---|---|---|
| 0 | 5 | 0 | 0 | 100% |
| 1 | 5 | 1 | 0 | 80% |
| 2 | 4 | 1 | 1 | 60% |
| 3 | 2 | 0 | 1 | 60% |
| 4 | 1 | 1 | 0 | 0% |
Kaplan–Meier multiplica, en cada tiempo con eventos, el factor (1 − eventos/personas en riesgo). Una censura aislada no baja la curva: esa persona deja de contribuir a los conjuntos de riesgo posteriores. Esta es la lógica del estimador de Kaplan y Meier (1958).
Un ejemplo manual de cinco personas lo hace visible: evento en el mes 1; un evento y una censura en el mes 2; censura en el mes 3; evento en el mes 4. La curva pasa de 1 a 4/5 = 0,80 y después a 0,80 × 3/4 = 0,60. En el mes 3 permanece en 0,60. La persona censurada exactamente en el mes 2 cuenta entre las cuatro en riesgo inmediatamente antes de ese tiempo. La documentación de summary.survfit explicita esta convención.
El último evento deja la estimación en cero con una sola persona en riesgo. Eso no demuestra certeza sobre la supervivencia poblacional. Los IC son puntuales, no una banda simultánea para toda la curva. Una meseta y un intervalo que no cambia tras una censura no garantizan que quede seguimiento abundante: lee siempre la tabla de riesgo.
03 · Lee el resultado
Lee el resultado
Con los datos sintéticos del ejemplo obtenemos:
| Grupo | Kaplan–Meier a 12 meses | IC puntual 95% | En riesgo justo antes de 12 meses |
|---|---|---|---|
| A | 65,12% | 56,48–72,47% | 85 |
| B | 78,63% | 70,85–84,56% | 98 |
En A, 85/150 = 56,7% no es la supervivencia estimada a 12 meses. Las 85 personas siguen bajo observación y sin evento justo antes de ese momento. Kaplan–Meier utiliza los conjuntos de riesgo en cada tiempo de evento, teniendo en cuenta cuándo termina el seguimiento; por eso estima 65,12%.
04 · Reproduce el análisis
Reproduce el análisis
En el navegador
- Abre Survival Lab y entra en la herramienta.
- Fija 150 personas por grupo, riesgo de evento en A a 12 meses de 0,30, HR de B frente a A de 0,65, seguimiento de 24 meses, probabilidad latente de pérdida a 12 meses de 0,15 y semilla 20261008. Introduce las probabilidades en la escala que muestre cada control.
- Pulsa Simular. Cambiar un control deja el resultado anterior visible hasta que vuelvas a simular; las descargas corresponden al último resultado ejecutado.
- Lee la curva escalonada, las marcas de censura, los IC puntuales del 95% y la tabla de personas en riesgo. La curva discontinua representa la verdad generadora, conocida únicamente porque los datos son simulados.
- Descarga datos observados, resumen, tabla de riesgo y script R. Conserva también los parámetros para documentar el escenario.
Ver la captura del Lab y su procedencia
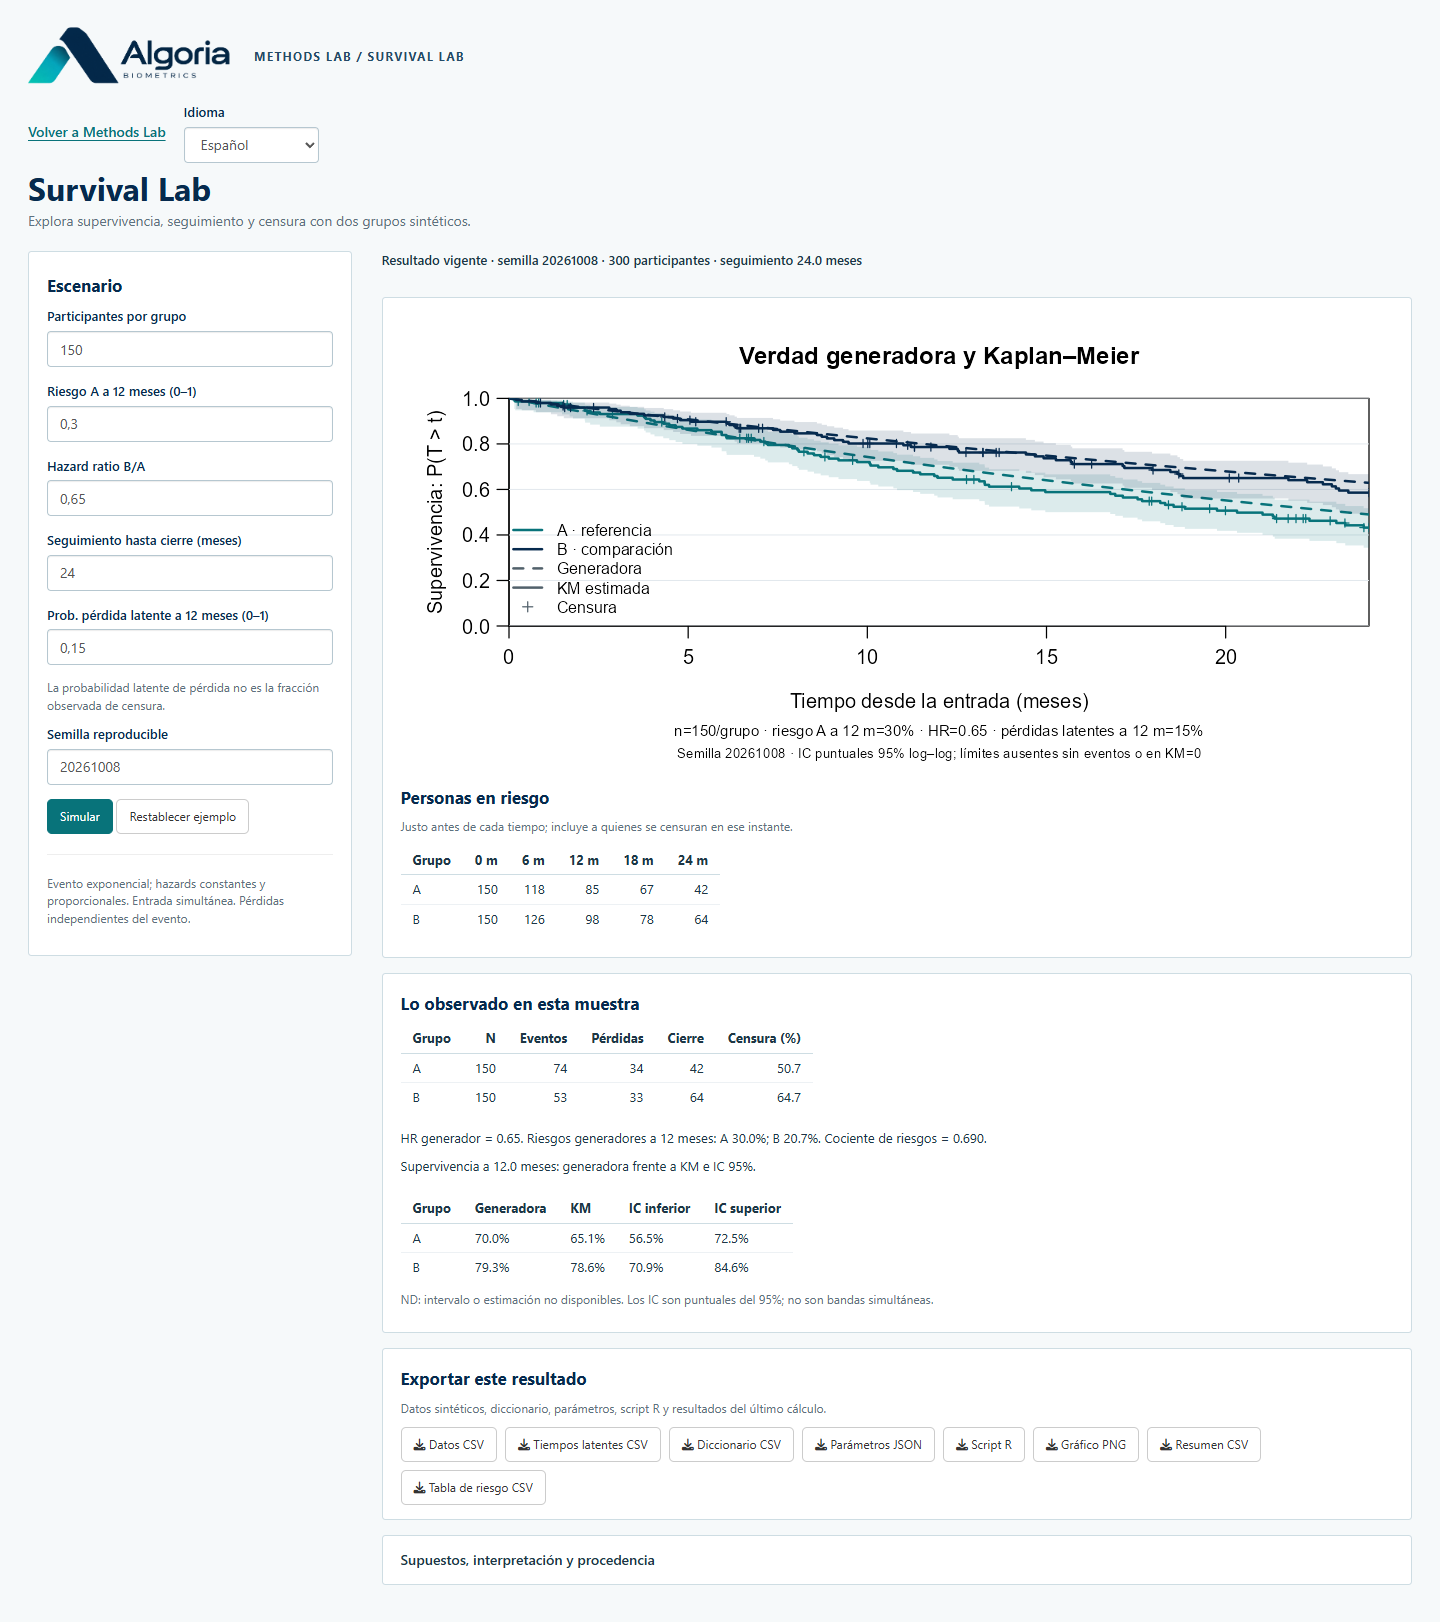
Captura de la aplicación Shiny local, con el mismo motor del Lab. Las bandas muestran IC puntuales; las curvas discontinuas muestran la supervivencia generadora. El resumen en pantalla usa un decimal; la tabla siguiente usa dos.
Con R / RStudio
Puedes hacer el mismo análisis fuera del laboratorio. RStudio
es la interfaz; survival es el paquete R que calcula
Kaplan–Meier, también utilizado por Survival Lab. Esta ruta
analiza el mismo CSV sin volver a simular los datos.
- Necesitas R y, para seguir las capturas, RStudio. Si falta
survival, ejecuta una vezinstall.packages("survival")en la consola de R. - Guarda el CSV del ejemplo y el script breve para survival en la misma carpeta. El CSV contiene los 300 registros observados del escenario anterior.
- Abre el script en RStudio con File → Open File. Selecciona Session → Set Working Directory → To Source File Location para que R encuentre el CSV sin rutas personales en el código.
- Pulsa Source. La consola muestra S(12), los límites del IC y las personas en riesgo. Plots muestra las curvas y las marcas de censura. El script valida el CSV antes del ajuste y está preparado específicamente para este ejemplo sintético.
El cálculo esencial es:
library(survival)

d <- read.csv("synthetic-data.csv")

d$group <- factor(d$group, levels = c("A", "B"))

fit <- survfit(Surv(time, event) ~ group, data = d,

               conf.type = "log-log", conf.int = 0.95)

summary(fit, times = 12, extend = FALSE)

summary(fit, times = c(0, 6, 12, 18, 24), extend = FALSE)
En este caso ficticio, event=1 representa fallecimiento
por cualquier causa; event=0, censura por la derecha.
time es el seguimiento observado en meses desde el
diagnóstico. Los IC se fijan explícitamente como log–log del 95%, como
en el Lab; el valor predeterminado del paquete es distinto.
extend=FALSE evita prolongar estimaciones más allá del
seguimiento observado. Véanse survfit
y summary.survfit.
Ver la captura de RStudio y su procedencia
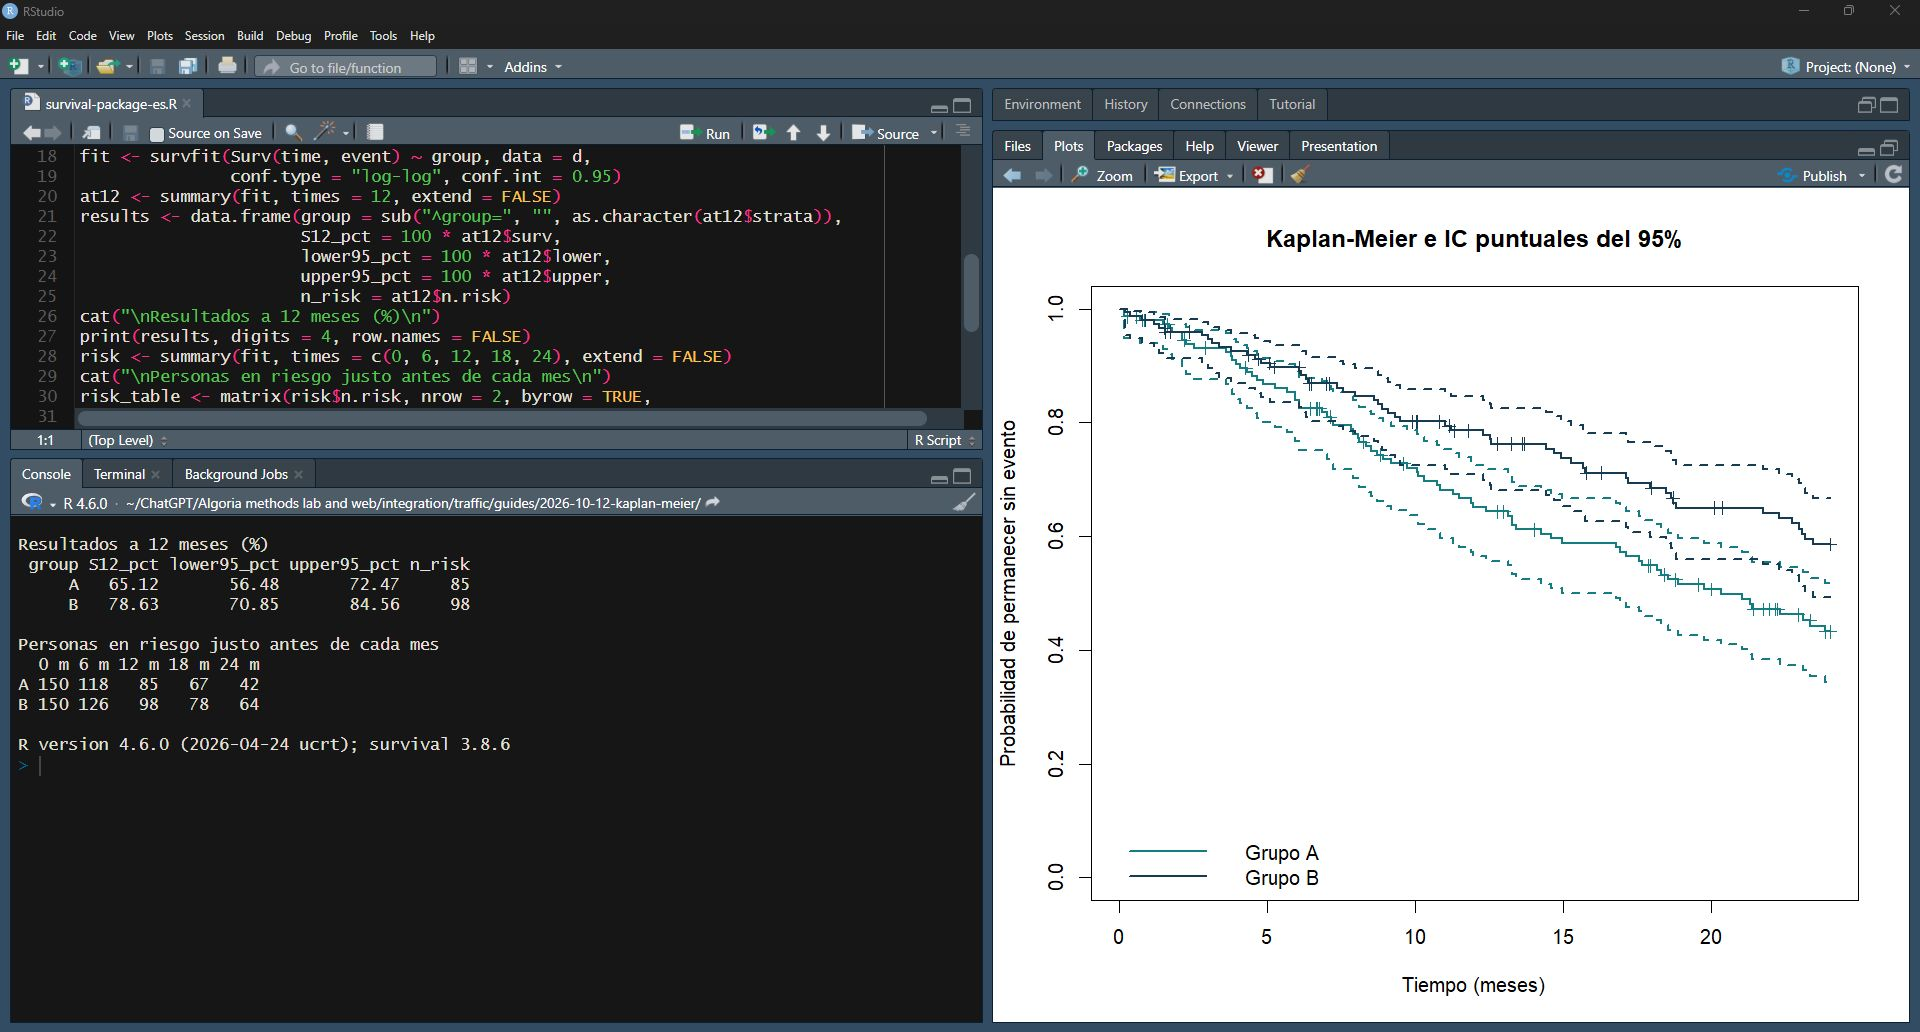
Captura real de RStudio. Las cruces indican censura y las líneas discontinuas delimitan los IC puntuales; este gráfico no incluye la verdad generadora.
S(12), ambos límites y todos los recuentos a 0, 6, 12, 18 y 24 meses
coinciden con el Lab. El aspecto del gráfico cambia porque se usa
plot.survfit(); el estimador es el mismo. Las versiones y
la comprobación numérica se documentan en el bloque técnico
opcional.
Conserva el mismo CSV para repetir exactamente la muestra.
05 · Supuestos y detalle técnico
Supuestos y detalle técnico
Para interpretar el caso necesitamos un evento y un inicio del seguimiento bien definidos, pacientes independientes y censura independiente del tiempo de fallecimiento dentro de cada grupo. En la simulación, las pérdidas se generan de forma independiente. En una cohorte real habría que justificar este supuesto: si se pierde con más frecuencia a pacientes cuyo pronóstico empeora, la estimación puede estar sesgada. Evalúa análisis de sensibilidad si la independencia no es defendible.
Kaplan–Meier no exige por sí mismo una distribución exponencial ni hazards proporcionales. Los riesgos competitivos, entrada tardía, eventos recurrentes y covariables cambiantes requieren otro planteamiento. Este laboratorio no permite importar datos reales ni incluye Cox, log-rank o potencia. La separación visual de curvas o el solapamiento de sus IC no constituyen un contraste entre grupos.
Detalle técnico opcional: simulación, recuentos y reproducibilidad
Cómo se genera el ejemplo
El generador utiliza eventos exponenciales, hazards constantes y proporcionales, entrada simultánea al seguimiento, pérdidas independientes y cierre común a 24 meses. Es un escenario didáctico simplificado; no está calibrado a una enfermedad ni a un tratamiento real.
En el generador, lambda_A = −log(0,70)/12 y lambda_B = 0,65 × lambda_A. Por ello, S_A(12) = 0,70 y S_B(12) = 0,70^0,65 = 0,793074: 70,00% y 79,31%, respectivamente. Son valores poblacionales de la simulación, distintos de las estimaciones obtenidas en una muestra. HR = 0,65 es un parámetro generador, no un efecto clínico estimado, y no significa que el riesgo de B sea 0,65 veces el de A.
| Fin de observación, hasta 24 meses | A | B |
|---|---|---|
| Evento (fallecimiento en el caso ficticio) | 74 | 53 |
| Pérdida | 34 | 33 |
| Cierre administrativo | 42 | 64 |
Estos recuentos abarcan 24 meses, no 12. Las proporciones censuradas son 76/150 y 97/150, incluyendo pérdidas y cierre administrativo. El parámetro 0,15 describe P(tiempo latente de pérdida ≤ 12); no es la proporción observada de censura. El evento puede ocurrir antes que la pérdida, y el cierre también produce censura.
Versiones y equivalencia
La referencia original se calculó con R 4.5.2 y survival 3.8-3. Las capturas reales de RStudio utilizan RStudio 2025.09.2+418, R 4.6.0 y survival 3.8-6. Ambos ejercicios breves se comprobaron frente a un cálculo nuevo del Lab y a la referencia original: curvas completas, S(12), límites y recuentos coinciden con tolerancia de 10⁻¹⁰. La comprobación cubre las versiones indicadas, no todas las versiones posibles.
El ajuste usa conf.type="log-log"; véase survfit.formula.
En Survival Lab, los límites log–log no se muestran cuando la
supervivencia estimada es 0 o 1. La misma semilla con otro generador no
garantiza los mismos registros. Los tiempos latentes del Lab explican la
simulación y no entran en el ajuste KM.
Reproducir también la simulación y el gráfico del Lab
Guarda el script R del ejemplo y,
si quieres inspeccionar los registros, el
CSV sintético. Ejecuta el script en una carpeta de resultados vacía,
con R y el paquete survival disponibles:
Rscript --vanilla survival-guide-es.REl script autónomo se genera con el mismo exportador de Survival Lab.
Crea survival-data.csv, survival-summary.csv y
survival-plot.png, e imprime las versiones utilizadas. No
requiere Shiny para reproducir el cálculo. Los nombres de salida son
fijos: usa una carpeta vacía para conservar resultados anteriores.
Esta ruta reproduce también el generador y el diseño del gráfico del Lab. La alternativa breve de RStudio reproduce el análisis del CSV con el gráfico estándar del paquete.
06 · Resuelve el caso
Resuelve el caso
Elige una respuesta y comprueba tu interpretación. Puedes abrir la explicación de cada pregunta.
La habilidad que puedes trasladar a una investigación es formular el evento y el tiempo cero, interpretar conjuntamente curva, IC y tabla de riesgo, y conservar los datos y el código para reproducir el resultado. Antes de aplicarla a una cohorte real, revisa cómo se definieron los grupos y por qué terminó el seguimiento.
Continúa en el Laboratorio de métodos. Para adaptar el análisis a un estudio, consulta Modelos longitudinales, supervivencia y sensibilidad.