
Guía práctica · Trial Planner + R · Datos sintéticos
Cómo planificar un ensayo con respuesta binaria
De una pregunta clínica a un tamaño muestral justificable: tasas esperadas, efecto relevante, potencia, asignación y resultados faltantes.
Objetivo: completar un escenario en Trial Planner, reproducirlo en R y explicar por qué el número cambia al cambiar los supuestos. El ejemplo principal asume respuesta del 25% con control y del 40% con tratamiento. Son cifras didácticas, sin atribución a un tratamiento o población reales.
Abrir Trial Planner · Leer la noticia de SatraGO que motiva la guía · Descargar código y datos
1. Definir qué significa responder
Imagina un ensayo paralelo con aleatorización individual a tratamiento experimental o control. Cada persona tiene una evaluación a las 24 semanas y un resultado binario: respuesta sí o no. La respuesta es beneficiosa. Antes de conocer los resultados se fijan el criterio clínico, la ventana de evaluación y las reglas ante tratamientos de rescate, suspensión y fallecimiento. Estas decisiones forman parte de la pregunta científica y no deberían improvisarse al analizar.
La población objetivo debe describirse con suficiente precisión para que las tasas previstas tengan sentido. La unidad de análisis será la persona; las observaciones deben ser independientes entre participantes. La comparación docente es la diferencia marginal de probabilidades, RD = pT − pC. No ajustamos por centros o covariables y no modelamos mediciones repetidas. Esas extensiones pueden ser necesarias en un protocolo real.
Hay dos umbrales que no debemos confundir. El criterio individual determina quién cuenta como respondedor. La diferencia objetivo entre grupos determina la alternativa para la que queremos potencia. En este ejemplo elegimos 15 puntos porcentuales como supuesto de trabajo; no afirmamos que esa cifra sea una diferencia mínima clínicamente importante validada.
2. Escribir los supuestos antes de abrir la calculadora
| Decisión | Supuesto |
|---|---|
| Respuesta con control | 25% |
| Respuesta con tratamiento | 40% |
| Efecto objetivo | RD +15 puntos; RR 1,60 |
| Contraste | Igualdad de riesgos; bilateral, alfa 0,05 |
| Potencia objetivo | 90% |
| Asignación tratamiento:control | 1:1 |
| Fracción común sin resultado utilizable | 10% |
La potencia se evalúa bajo pC=0,25 y pT=0,40. El contraste sigue siendo H0: pT=pC; los 15 puntos no se convierten en un margen que la estimación deba superar. Diseñar para detectar una diferencia y demostrar que supera un umbral clínico son objetivos estadísticos diferentes.
Una potencia del 90% es una probabilidad de rechazo bajo esa alternativa y ese procedimiento, aproximada en este caso. No es una probabilidad del 90% de que el tratamiento funcione, ni de éxito global del programa. Elegir entre un contraste unilateral y bilateral exige una justificación previa; no debe depender de qué opción produzca un número menor.
3. Resolverlo en Trial Planner y entender el redondeo
- Abre Trial Planner en español y selecciona el cálculo de tamaño muestral.
- Introduce control 25%, tratamiento 40%, potencia 90%, alfa 0,05, contraste bilateral y asignación 1:1. En interpretación del evento, selecciona la opción favorable: aquí el evento es responder.
- Comprueba primero el resultado con 0% ausente: 203 evaluables por grupo, 406 en total.
- Cambia la fracción común sin resultado utilizable al 10%: 226 que aleatorizar por grupo, 452 en total.
- Guarda las entradas y el método junto con el resultado; el total aislado no documenta el diseño.
Para una asignación 1:1, cada bloque contiene una persona por brazo. Con 203 bloques de información y retención del 90%, el cálculo es techo(203/0,90)=226 bloques aleatorizados. No se redondean los grupos por separado de una forma que rompa la asignación. El valor calculado es el mínimo entero para alcanzar el objetivo dentro del método, no una garantía de potencia exacta en una muestra finita.
Este ajuste compensa recuentos bajo una retención común y condicional. No integra la potencia sobre todas las posibles realizaciones aleatorias de pérdidas. Tampoco indica que debamos excluir del análisis a quienes tengan datos incompletos. La estrategia de estimación requiere su propio planteamiento.
4. Qué método calcula ese número
Trial Planner utiliza una aproximación normal para dos proporciones independientes, sin corrección de continuidad. Combina una varianza bajo igualdad de riesgos con una varianza bajo la alternativa. En un contraste bilateral incorpora las probabilidades de rechazo en ambas colas. El script descargable muestra las operaciones con qnorm y pnorm; no oculta una fórmula distinta detrás de una etiqueta común.
p̄ = (nTpT + nCpC)/(nT+nC)
V0 = p̄(1−p̄)(1/nT+1/nC)
V1 = pT(1−pT)/nT + pC(1−pC)/nC
Con d=pT−pC y z=Φ−1(1−α/2): potencia = Φ((d−z√V0)/√V1) + Φ((−d−z√V0)/√V1).
La búsqueda aumenta el número de bloques y localiza el primer entero que alcanza la potencia objetivo. Para asignación equilibrada, la potencia se contrasta además con stats::power.prop.test(strict=TRUE). En esa función, n es el tamaño por grupo y strict=TRUE conserva ambas colas. La comparación verifica este procedimiento, no todos los posibles métodos de tamaño muestral. Documentación oficial de R.
La aproximación puede diferir de la probabilidad de rechazo del test aplicado a recuentos binomiales reales. Con probabilidades extremas o celdas pequeñas hay que evaluar su adecuación y considerar métodos exactos o simulación. Una advertencia por celdas esperadas pequeñas ayuda a detectar problemas, pero superar un recuento determinado no certifica la aproximación.
5. Explorar nueve escenarios, no una única cifra
La tabla conserva alfa bilateral 0,05, potencia 90%, asignación 1:1 y 10% sin resultado utilizable. Cambian la respuesta de control y la RD asumida. En cada celda se plantea un ensayo futuro distinto; los resultados no son intervalos de confianza ni probabilidades asignadas a los escenarios.
| Control | Tratamiento | RD (pp) | Evaluables por grupo | Total que aleatorizar |
|---|---|---|---|---|
| 15% | 25% | 10 | 335 | 746 |
| 25% | 35% | 10 | 440 | 978 |
| 35% | 45% | 10 | 503 | 1118 |
| 15% | 30% | 15 | 161 | 358 |
| 25% | 40% | 15 | 203 | 452 |
| 35% | 50% | 15 | 227 | 506 |
| 15% | 35% | 20 | 97 | 216 |
| 25% | 45% | 20 | 118 | 264 |
| 35% | 55% | 20 | 128 | 286 |
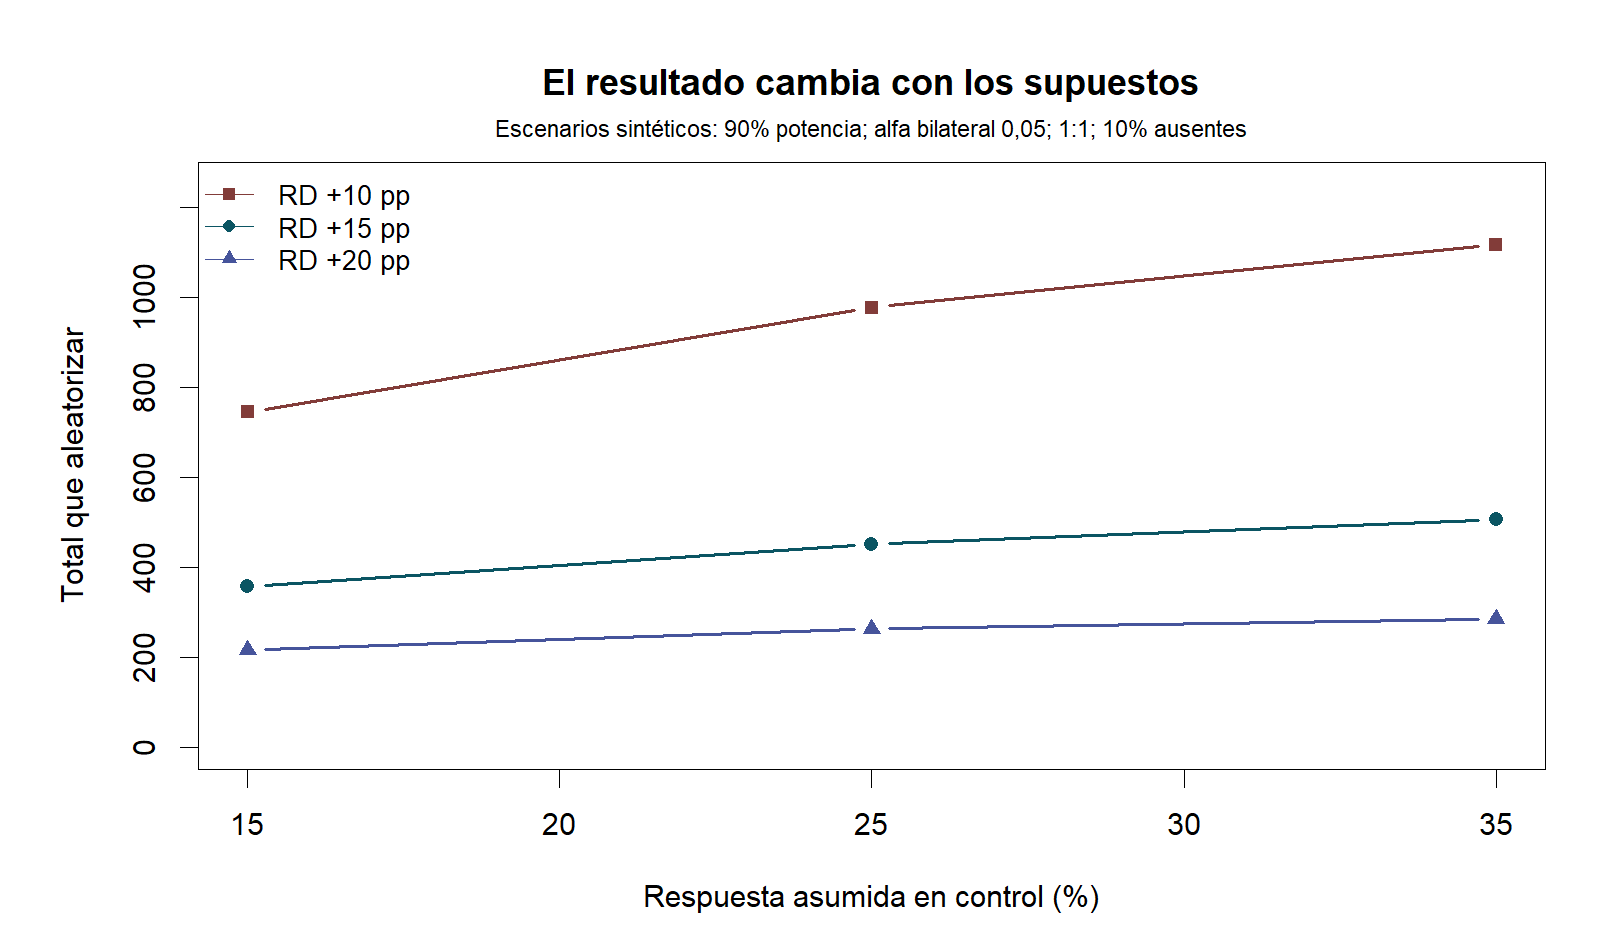
Con control del 25%, pasar de una RD asumida de 20 puntos a 10 puntos lleva de 264 a 978 participantes que aleatorizar. La mayor exigencia no es un fallo de la calculadora: estamos intentando detectar una señal menor frente a la variabilidad. Elegir el escenario más favorable para encajar un presupuesto cambia la pregunta que el ensayo podrá responder.
Al variar la respuesta basal hay que declarar qué efecto permanece fijo. Si mantenemos RD=15 puntos, control del 15% implica tratamiento del 30%; control del 35% implica tratamiento del 50%. Si mantenemos RR=1,60, esos tratamientos pasarían a 24% y 56%. No son las mismas alternativas y no deberían mezclarse en una gráfica sin explicación.
6. Asignación desigual y resultados ausentes
Con los supuestos base, la asignación 2:1 requiere 154 evaluables en control y 308 en tratamiento. Con 10% ausente se aleatorizan 172 y 344, total 516. Frente al total de 452 con 1:1, reclutamos más personas. Una asignación desigual puede tener razones clínicas u operativas, pero su coste de información debe hacerse visible.
Con asignación 1:1, cambiar la ausencia prevista de 10% a 20% aumenta el total aleatorizado de 452 a 508. Esa operación no corrige sesgo. Si las personas sin medición tienen resultados sistemáticamente peores, el problema no se reduce a recuperar el mismo número de observaciones. Debemos planear seguimiento, recogida de razones, análisis y sensibilidad.
MCAR describe ausencia independiente de los datos relevantes; MAR condiciona esa independencia a lo observado; MNAR permite dependencia de lo no observado. MAR no se confirma simplemente examinando las filas completas. El supuesto debe justificarse y acompañarse de sensibilidad cuando resulte material. Los eventos intercurrentes, como rescate o suspensión, requieren además una estrategia coherente con el estimando, siguiendo ICH E9(R1).
7. Reproducir y explorar en R
Descarga el script, guárdalo en una carpeta y ábrelo en RStudio. No necesita instalar paquetes: utiliza R base, stats, graphics y grDevices. Las rutas de salida se eligen explícitamente. Este comando crea los CSV, las figuras y el registro de sesión:
source("binary-planning.R")
run_exercise("results")
plan_binary(0.25, 0.40, missing = 0.10)
plan_binary(0.25, 0.40, allocation = c(2, 1), missing = 0.10)
stats::power.prop.test(n = 203, p1 = 0.25, p2 = 0.40,
  sig.level = 0.05, alternative = "two.sided", strict = TRUE)
El CSV de 400 participantes contiene identificador sintético, grupo y respuesta, generado con semilla 20261019. Es otro ejercicio: observar una muestra concreta no equivale a fijar de nuevo sus probabilidades generadoras como si fueran conocidas. El archivo de análisis aplica prop.test(correct=FALSE) y muestra estimación, intervalo y contraste para esos datos sintéticos. No reproduce el análisis ajustado de SatraGO.
En esta realización aparecen 63 respuestas de 200 en control (31,5%) y 78 de 200 en tratamiento (39,0%). La diferencia observada es 7,5 puntos, con IC del 95% de aproximadamente −1,83 a 16,83 y p≈0,116. La muestra ilustra variación de muestreo: una potencia prospectiva alta no garantiza que una realización concreta alcance significación. No recalculamos «potencia observada» para interpretar este resultado.
El script exporta también las estimaciones publicadas de SatraGO en un archivo de resumen agregado, claramente separado de los participantes sintéticos. Las figuras clínicas se dibujan con los intervalos publicados del 95,03%; no se generan intervalos nuevos a partir de porcentajes redondeados. El archivo de sesión registra la versión realmente ejecutada para facilitar auditoría y reproducción.
8. Cuatro ejercicios con solución
1. ¿Por qué no basta con decir «esperamos duplicar la respuesta»?
Porque el riesgo basal cambia la alternativa y la varianza. Pasar de 5% a 10% y de 20% a 40% comparte RR=2 pero representa diferencias absolutas de 5 y 20 puntos. Declara ambas tasas y justifica su plausibilidad antes de calcular.
2. ¿203 por grupo significa que debemos aleatorizar 406?
Solo con el supuesto de disponer de todos los resultados utilizables. Con 10% común ausente, techo(203/0,90)=226 por grupo: 452 en total. Ese aumento no define el análisis de datos faltantes ni elimina su posible sesgo.
3. ¿Un ensayo con p≈0,086 y otro con p≈0,0077 tienen efectos diferentes?
No puede concluirse a partir de esas etiquetas. En el ejemplo sintético de estimaciones independientes de 12±7 y 16±6 puntos, la diferencia es 4 puntos, error estándar 9,22, IC del 95% aproximadamente −14,1 a 22,1 y p≈0,664. Tampoco se ha demostrado equivalencia.
4. ¿Debemos copiar la mayor diferencia observada de SatraGO?
No de forma automática. Revisa población, definición de respuesta, horizonte, estimando y método; justifica una diferencia importante y plausible y explora incertidumbre. La potencia calculada a posteriori con el efecto observado no añade una nueva medida independiente de evidencia.
9. Descargas y siguiente paso
Antes de utilizar un número en un protocolo, documenta por qué elegiste las tasas, quién considera importante la diferencia, el estimando, el análisis principal y sus sensibilidades. DELTA² aporta un marco para justificar el efecto objetivo. Esta guía cubre un desenlace binario, dos grupos independientes y un contraste final de superioridad. Supervivencia, no inferioridad, clústeres, análisis interinos o multiplicidad necesitan un diseño específico.
La noticia desarrollada de SatraGO permite volver al contexto clínico después del ejercicio. Mantén separadas tres preguntas: qué se observó, qué inferimos bajo los supuestos y para qué escenario estamos planificando el siguiente estudio.